Baza wektorowa w 30 sekund
- Gdzie się chowa: sama baza wektorowa rzadko jest celem - zwykle jest częścią systemu RAG albo chatbota odpowiadającego na podstawie dokumentów firmy.
- Czym różni się od zwykłej bazy danych: zwykła baza szuka dokładnego dopasowania, wektorowa szuka najbliższego sąsiada w przestrzeni liczb, nawet gdy nie ma ani jednego wspólnego słowa.
- Kiedy nie musi być osobnym systemem: przy mniejszej skali rozszerzenie typu pgvector w bazie, którą firma już ma, zwykle wystarczy.
Jak działa baza wektorowa?
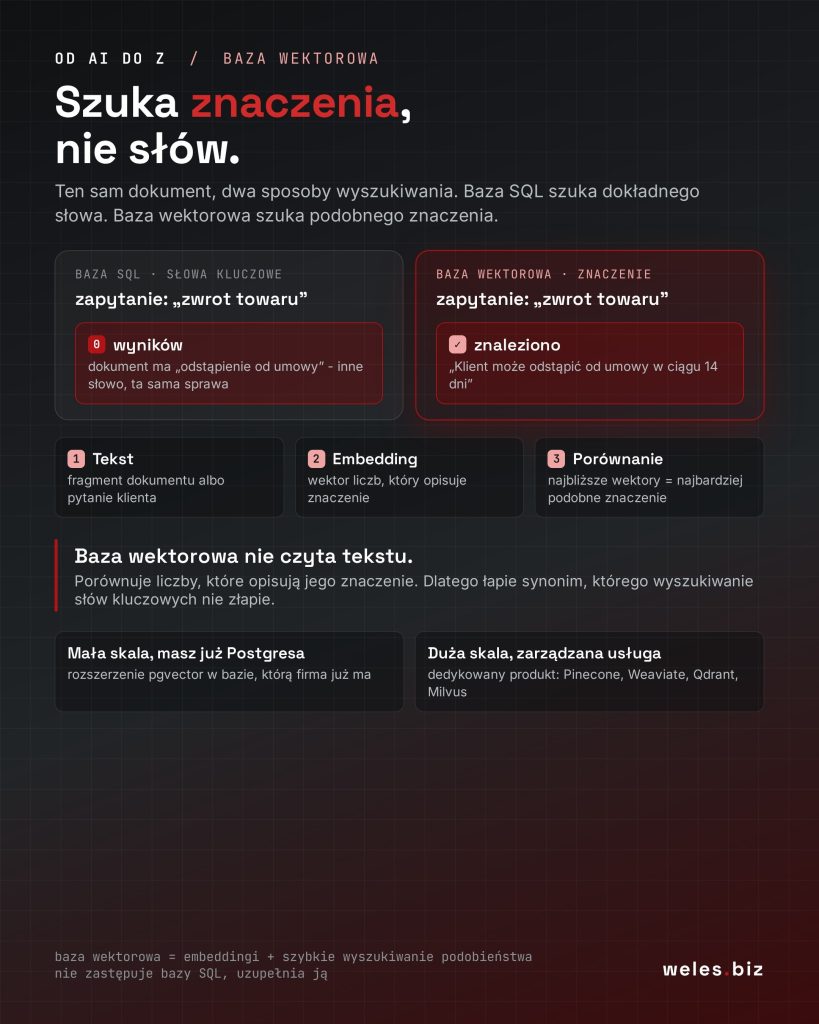
Baza wektorowa działa w trzech krokach: zamienia tekst na wektor liczb, zapisuje ten wektor razem z oryginałem, a przy wyszukiwaniu porównuje wektor zapytania z zapisanymi wektorami i zwraca te najbardziej podobne. Sam wektor nazywa się embeddingiem: to lista liczb, w której odległość między dwoma wektorami pokazuje, jak blisko są sobie znaczenia. Jak model embeddingowy go tworzy, ile ma liczb i który model wybrać do polskiego tekstu, opisujemy w osobnym haśle. Tutaj zajmujemy się tym, co dzieje się z wektorami dalej: gdzie je trzymać i jak je przeszukiwać.
Dzięki temu zapytanie „zwrot towaru” znajdzie fragment regulaminu mówiący o „odstąpieniu od umowy”, mimo że te dwa sformułowania nie mają ani jednego wspólnego słowa. Model wcześniej zamienił obie frazy na wektory, a te wektory wyszły sobie bliskie, bo znaczą podobną rzecz.
Przy milionach wektorów porównanie każdego z każdym byłoby zbyt wolne, więc bazy wektorowe budują indeks, który przeszukuje tylko najbardziej obiecujące rejony przestrzeni liczb. Jeden z najpopularniejszych takich indeksów, HNSW (Hierarchical Navigable Small World), opisali w pracy z 2016 r. Yu. Malkov i D. Yashunin. Taki indeks nie gwarantuje znalezienia absolutnie najbliższego wektora, tylko wektory bliskie z dużą dozą prawdopodobieństwa (approximate nearest neighbor), za to odpowiada w milisekundach, nie sekundach.
Czym baza wektorowa różni się od zwykłej bazy danych?
Różnica jest w tym, czego obie bazy uznają za „trafienie”. Zwykła baza SQL szuka dokładnego dopasowania albo dopasowania wzorca (np. WHERE, LIKE): albo warunek jest spełniony, albo nie. Baza wektorowa nie sprawdza warunku, tylko liczy odległość i zwraca kilka wyników najbardziej podobnych, nawet jeśli żaden nie jest idealny.
| Baza SQL / wyszukiwanie słów kluczowych | Baza wektorowa | |
|---|---|---|
| Czego szuka | dokładnego dopasowania albo wzorca w tekście | najbardziej podobnego znaczenia |
| Co zwraca | wiersze spełniające warunek albo nic | kilka-kilkadziesiąt najbliższych wyników, zawsze jakiś |
| Radzi sobie z synonimem | nie, „zwrot” nie znajdzie „odstąpienia” | tak, o to właśnie chodzi |
| Radzi sobie z numerem faktury, nazwą własną | tak, to jej naturalne zastosowanie | słabiej, liczby i nazwy własne nie niosą „znaczenia” do porównania |
| Kiedy wybrać | wyszukiwanie po konkretnych danych, filtrach, kodach | wyszukiwanie po treści pytania, chatbot na dokumentach |
W praktyce systemy produkcyjne rzadko wybierają jedno albo drugie. Wyszukiwanie hybrydowe łączy dopasowanie słów (dobre dla numerów faktur i nazw) z podobieństwem wektorów (dobre dla pytań w naturalnym języku). Nawet duże wyszukiwarki tekstowe, takie jak Elasticsearch czy OpenSearch, dodały własne wyszukiwanie wektorowe jako kolejną funkcję, więc granica między „bazą tekstową” i „bazą wektorową” coraz częściej jest linią w tym samym produkcie, nie wyborem dwóch różnych systemów.
Baza wektorowa a RAG: do czego dokładnie służy?
W systemie RAG baza wektorowa jest magazynem, z którego model wyciąga fragmenty do odpowiedzi: przed napisaniem odpowiedzi model najpierw szuka w niej fragmentów podobnych do pytania, a dopiero potem pisze, trzymając się tego, co znalazł. Cały mechanizm RAG, łącznie z regułą „cytuj albo się wstrzymaj”, opisujemy w haśle RAG - tutaj nie powtarzamy tej definicji, tylko patrzymy bliżej na sam magazyn.
To nie jest teoria bez przykładu. Nasza usługa automatyzacji księgowości obejmuje chatbota na dokumentach firmy (RAG), który odpowiada z przypisem do konkretnego dokumentu albo mówi, że nie wie. Żeby to działało, system musi mieć gdzieś zapisane wektory wszystkich fragmentów faktur, umów i procedur - to właśnie rola bazy wektorowej w tej usłudze.
Baza wektorowa może być też jednym z narzędzi, po które sięga agent AI, np. przez MCP: agent sam decyduje, kiedy przeszukać dokumenty, a kiedy sięgnąć po inne narzędzie. Sama baza wektorowa niczego nie decyduje, tylko odpowiada na zapytanie „co jest podobne do tego wektora”.
Jakie są rodzaje baz wektorowych?
Są trzy drogi do tej samej funkcji: dodać wyszukiwanie wektorowe do bazy, którą firma już ma, kupić produkt zbudowany specjalnie do tego celu albo dodać je do istniejącej wyszukiwarki tekstowej.
| Droga | Przykłady | Kiedy ma sens |
|---|---|---|
| Rozszerzenie istniejącej bazy | pgvector (rozszerzenie PostgreSQL, pierwsza wersja 20.04.2021) | firma już korzysta z Postgresa, skala umiarkowana, ważna prostota: jedna baza, jedna kopia zapasowa, jedna transakcja |
| Dedykowany produkt | Pinecone, Weaviate, Qdrant, Milvus, Chroma | duża skala, potrzeba zarządzanej usługi bez własnej administracji, albo funkcje, których pgvector nie ma |
| Wyszukiwarka tekstowa z funkcją wektorową | Elasticsearch, OpenSearch | firma już ma taką wyszukiwarkę do innych celów i chce dodać wyszukiwanie po znaczeniu bez nowego systemu |
Żadna z tych dróg nie jest „lepsza” w oderwaniu od sytuacji. Przy dużych indeksach pgvector wymaga strojenia: budowa indeksu HNSW zużywa dużo pamięci, a jego przebudowa na produkcyjnej bazie bywa uciążliwa. Opisuje to Alex Jacobs w tekście The Case Against pgvector. Przy mniejszej skali te problemy zwykle się nie pojawiają.
Czy moja firma potrzebuje dedykowanej bazy wektorowej?
Zwykle nie na początek, i to dobra wiadomość, bo oznacza mniej nowych systemów do utrzymania. Znajdź swoją sytuację:
Jedna pułapka przy liczeniu skali: liczy się liczba wektorów, nie liczba dokumentów. Dokument przed zapisem dzieli się na fragmenty (chunking), bo jeden wektor nie powinien reprezentować całej umowy naraz, tylko jej kawałek. Regulamin na dziesięć stron to zwykle od kilkunastu do kilkudziesięciu wektorów, zależnie od długości fragmentów - nie jeden. Firma, która liczy „mamy tylko 500 dokumentów”, może w praktyce mieć kilkanaście tysięcy wektorów albo więcej.
Ile kosztuje baza wektorowa?
Koszt zależy od drogi z tabeli wyżej. Rozszerzenie istniejącej bazy (pgvector) nie ma własnej opłaty: płacisz tyle, co za Postgresa, a kosztem jest czas wdrożenia i dobrania parametrów indeksu. Dedykowane usługi w chmurze mają własne cenniki, które zmieniają się częściej niż inne elementy tego tematu. Pinecone, stan na 19 października 2026 r., ma darmowy plan (2 GB danych, 2 mln jednostek zapisu i 1 mln jednostek odczytu miesięcznie), a pierwszy płatny poziom (Builder) kosztuje 20 USD miesięcznie ryczałtem.
- Koszt, który łatwo przeoczyć: przeliczenie wektorów. Zmiana modelu embeddingów (np. na nowszy, dokładniejszy) nie jest aktualizacją w miejscu - trzeba przeliczyć wszystkie zapisane fragmenty na nowo, bo wektory z różnych modeli nie są ze sobą porównywalne.
- Koszt zapytań do modelu embeddingów. Każdy fragment dokumentu i każde zapytanie użytkownika trzeba najpierw zamienić na wektor, co kosztuje tokeny, zwykle niewiele w porównaniu z kosztem samej odpowiedzi modelu. Aktualne ceny modeli są w haśle embedding.
Co może pójść źle? Ryzyka i bezpieczeństwo danych
Baza wektorowa przechowuje treść dokumentów w innej formie, nie usuwa z niej ryzyk, które te dokumenty już miały.
- Dane osobowe trafiają do wektorów tak samo, jak do tekstu. Jeśli dokument zawiera dane klienta, embedding tego fragmentu jest pochodną tych danych, a z wektora da się odtworzyć sporą część tekstu (badanie opisujemy w haśle embedding). Przy usłudze w chmurze warto zapytać dostawcę, gdzie fizycznie są serwery i czy podpisze umowę powierzenia przetwarzania danych.
- Zapisywanie bez kontroli zanieczyszcza wyszukiwanie. Jeśli do bazy wpada też treść z zewnątrz (np. mail klienta), ktoś może spreparować fragment, który podszywa się pod oficjalny dokument - mechanizm jest bliski temu, co opisujemy w haśle prompt injection.
- Brak wyniku to nie błąd, tylko informacja. Gdy wyszukiwanie nic nie znajdzie, model i tak może spróbować odpowiedzieć z pamięci. Dlatego reguła „cytuj albo się wstrzymaj” (opisana w haśle halucynacje AI) jest równie ważna jak sama baza.
Zanim wdrożysz bazę wektorową
- Policz realną liczbę wektorów (dokumenty razy liczba fragmentów), nie liczbę dokumentów.
- Sprawdź, czy baza, którą już masz, ma rozszerzenie wektorowe (np. pgvector dla PostgreSQL).
- Ustal, gdzie fizycznie będą dane, jeśli wybierasz usługę w chmurze, i czy dostawca podpisze umowę powierzenia.
- Zapisz, jakiego modelu embeddingów używasz. Zmiana modelu wymaga przeliczenia wszystkich wektorów od nowa.
- Dodaj regułę „cytuj albo się wstrzymaj”, żeby model nie zgadywał, gdy wyszukiwanie nic nie znajdzie.
- Przetestuj wyszukiwanie po numerach i nazwach własnych - jeśli wypada słabo, dodaj wyszukiwanie hybrydowe (słowa i znaczenie razem).
Najczęstsze pytania
Czy baza wektorowa zastąpi zwykłą bazę danych firmy?
Nie. Dane transakcyjne, faktury, stany magazynowe i tak dalej zostają w zwykłej bazie SQL, która gwarantuje dokładność i integralność. Baza wektorowa dochodzi jako dodatkowy magazyn do jednego konkretnego zadania: wyszukiwania po znaczeniu.
Czym baza wektorowa różni się od wyszukiwania semantycznego?
Baza wektorowa to magazyn i mechanizm wyszukiwania. Wyszukiwanie semantyczne to zastosowanie, czyli wyszukiwanie po znaczeniu zapytania, a nie po dokładnych słowach - do tego zastosowania bazę wektorową najczęściej się wykorzystuje, ale można je też częściowo zrealizować innymi metodami.
Czy mogę zacząć od pgvector i później przejść na dedykowaną bazę?
Tak, to częsta droga. Zapytania do bazy wektorowej idą zwykle przez prostą warstwę w kodzie aplikacji, więc zmiana samego magazynu danych nie wymaga przepisywania całego systemu - trzeba tylko ponownie wczytać wektory do nowej bazy.
Dokumenty firmy a wyszukiwanie po znaczeniu
Jeśli z kart wyżej wyszło „to dla nas” albo nie masz pewności, czy ta technologia jest Ci potrzebna, zacznijmy od pytań, które klienci i pracownicy najczęściej zadają. Czasem odpowiedzią jest baza wektorowa i chatbot na dokumentach, a czasem zwykłe uporządkowanie plików. Szczegóły: automatyzacja księgowości, kontakt.
Stan na 19 października 2026 r. Cenniki dostawców baz wektorowych zmieniają się często, więc aktualizujemy to hasło, gdy coś się zmieni istotnie.
Źródła
- OpenAI, Embeddings (definicja embeddingu).
- pgvector, CHANGELOG (wersja 0.1.0, 20.04.2021).
- Malkov Y., Yashunin D., Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs, arXiv 1603.09320, 30.03.2016.
- Pinecone, cennik, odczyt 19.10.2026.
- Alex Jacobs, The Case Against pgvector, 29.10.2025.
- WELES, hasła embedding i RAG oraz usługa automatyzacja księgowości (chatbot na dokumentach firmy, reguła „cytuj albo się wstrzymaj”).
To hasło dotyczy bazy wektorowej jako technologii AI, czyli magazynu embeddingów. Jeśli chodziło Ci o „bazę” w sensie algebry liniowej (zbiór wektorów rozpinających przestrzeń) albo „grafiki wektorowej” (obrazy opisane krzywymi, np. pliki SVG) - to inne, niezwiązane znaczenia tego samego słowa.