Halucynacje AI w 30 sekund
- Skąd się biorą: model uczy się przewidywać prawdopodobny tekst, a testy nagradzają go za zgadywanie bardziej niż za „nie wiem”.
- Gdzie najczęściej: przy rzadkich faktach (mała firma, niszowy przepis, konkretny przypis) i tam, gdzie odpowiedź ma przewidywalny kształt.
- Co działa: źródło w kontekście, wymóg cytatu, prawo do odpowiedzi „nie wiem” i człowiek przy decyzjach, które kosztują.
Dlaczego AI zmyśla?
Bo model językowy nie sprawdza faktów, tylko układa najbardziej prawdopodobną odpowiedź. Jeśli o czymś czytał tysiące razy (stolica Francji), prawdopodobna odpowiedź jest zwykle prawdziwa. Jeśli fakt jest rzadki (data urodzin mało znanej osoby, prezes małej firmy), model nie ma się na czym oprzeć, a i tak produkuje tekst, który brzmi jak odpowiedź.
Badacze OpenAI opisali we wrześniu 2025 r., dlaczego to zjawisko nie znika. Halucynacje powstają już przy wstępnym uczeniu modelu, a utrwalają się, bo sposób oceniania modeli nagradza zgadywanie zamiast przyznania się do niewiedzy. To jak test wielokrotnego wyboru bez punktów ujemnych: kto strzela, wypada lepiej niż ten, kto zostawia puste pole. W ich własnym porównaniu model, który częściej mówił „nie wiem” (52% pytań), popełnił błąd w 26% odpowiedzi. Model, który prawie nigdy nie odmawiał (1%), mylił się w 75%, choć trafnych odpowiedzi miał niemal tyle samo.
Jest też drugi, mniej oczywisty typ błędu: wiedza zatrzymana na dacie treningu. Model podaje stan sprzed kilku miesięcy w czasie teraźniejszym, bez żadnego „według moich danych z…”. W naszym teście jeden z modeli napisał w październiku 2026 r., że KSeF „nie wszedł jeszcze w życie”.
Jak wygląda halucynacja w praktyce? Nasz test
16 października 2026 r. zadaliśmy czterem popularnym modelom (GPT-5.6 Luna, Gemini 3.8 Flash, Claude Haiku 5.5 i Llama 4 Scout) pytania, na które nie ma prawdziwej odpowiedzi albo model nie może jej znać. Pytaliśmy przez API, bez wyszukiwania w sieci, żeby zobaczyć, co robi sam model, gdy nie ma źródła. Cały test kosztował 2 centy.
| Pytanie | Co się stało |
|---|---|
| Czym zajmuje się firma, której nazwę wymyśliliśmy, kto jest prezesem i ilu ma pracowników? | W 12 z 16 odpowiedzi model podał branżę, prezesa i zatrudnienie. Za każdym razem innego prezesa. |
| Podaj 3 recenzowane artykuły o wpływie KSeF na koszty biur rachunkowych. | Dwa modele podały po trzy artykuły z autorami, tomami i stronami. Numery DOI od jednego z nich istnieją, ale prowadzą do tekstów o funduszu inwestycji lokalnych i o kosztach ochrony lasów. |
| Kto założył WELES (weles.biz) i ile kosztują jej usługi? | Trzy modele na cztery wymyśliły założyciela, branżę albo cennik. Raz z kwotami w dolarach. |
| Co przewiduje art. 7 nieistniejącej ustawy o ewidencji pracy zdalnej? | Żaden model nie zmyślił. Pytanie było „za dziwne”, model rozpoznał, że nie zna takiej ustawy. |
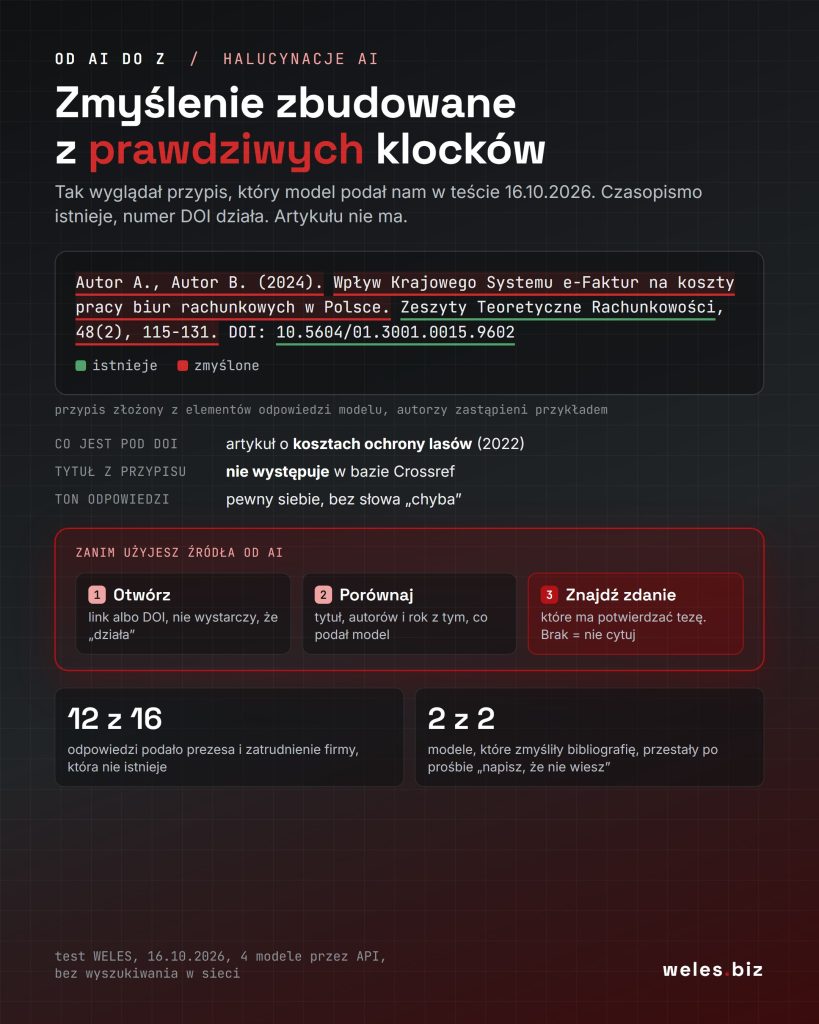
Dwa wnioski są ważniejsze od samych liczb. Po pierwsze, zmyślenie buduje się z prawdziwych klocków: istniejące czasopismo, działający numer DOI, nazwiska brzmiące jak polscy ekonomiści. Sprawdzenie „czy link działa” je przepuszcza. Trzeba otworzyć źródło i porównać tytuł. Po drugie, halucynacji najłatwiej spodziewać się tam, gdzie pytanie wygląda zwyczajnie, a odpowiedź ma przewidywalny kształt: prezes, liczba pracowników, bibliografia. To nie jest ranking modeli, bo próba jest mała, ale jeden z czterech modeli nie zmyślił ani razu, więc różnice są realne.
Co AI mówi o Twojej firmie?
Jeśli firma jest mała albo nowa, model najpewniej jej nie zna, a mimo to może odpowiedzieć z pełnym przekonaniem. Sprawdziliśmy to na sobie: na pytanie o WELES modele przypisywały nam wymyślonych założycieli, cudze branże i cennik, którego nie publikujemy. Nazwisk z tych odpowiedzi celowo nie powtarzamy, bo mogą należeć do prawdziwych ludzi.
Z wyszukiwaniem w sieci (ChatGPT search, Gemini, AI Overviews w Google) jest lepiej, bo model dostaje źródła. Ale tylko wtedy, gdy w sieci są spójne i łatwe do znalezienia dane o firmie. Analiza Ahrefs z 75 tys. marek pokazała, że widoczność w AI Overviews wyraźnie mocniej wiąże się z liczbą wzmianek o marce w sieci niż z liczbą linków. Co możesz zrobić:
- Jedno źródło prawdy na stronie: kto prowadzi firmę, co robi, czego nie robi, gdzie działa. Prostym językiem, w tekście, a nie tylko na grafice.
- Te same dane wszędzie: profil firmy w Google, KRS lub CEIDG, LinkedIn, katalogi branżowe. Sprzeczne informacje model sklei w trzecią, nieprawdziwą.
- Sprawdzaj regularnie: raz w miesiącu zadaj ChatGPT, Gemini i Perplexity te same 5 pytań o firmę i zapisz odpowiedzi. Zmiany zobaczysz szybciej niż klienci.
- Nie walcz z odpowiedzią, popraw źródła. Na odpowiedź modelu nie ma formularza reklamacji. Działa to, co model przeczyta przy następnym wyszukiwaniu.
Gdy AI podaje nieprawdę o konkretnym człowieku, wchodzi w grę RODO. W marcu 2025 r. organizacja noyb złożyła w Norwegii skargę na OpenAI w imieniu mężczyzny, którego ChatGPT opisał jako skazanego mordercę własnych dzieci. Podstawą jest zasada prawidłowości danych osobowych.
Jak często AI halucynuje?
Nie ma jednej liczby, bo wszystko zależy od zadania. Model streszczający dokument, który dostał, myli się dużo rzadziej niż model odpowiadający z pamięci o rzadkich faktach. Teksty, które podają „AI myli się w X% przypadków”, mieszają te dwie sytuacje.
| Zadanie | Odsetek halucynacji | Źródło |
|---|---|---|
| Streszczenie podanego artykułu | od 1,8% do ponad 20%, zależnie od modelu | Vectara, ranking z 22.09.2026 |
| Pytania o fakty z życia znanych osób | 16% (o1), 33% (o3), 48% (o4-mini) | OpenAI, karta modeli, 16.04.2025 |
| Pytania prawne do ogólnych modeli | od 58% (GPT-4) do 88% (Llama 2) | Dahl i in., Stanford, 2024 |
| Płatne narzędzia prawnicze z wyszukiwaniem w bazie | od 17% do 33% | Magesh i in., Stanford, 2024 |
| Nazwy bibliotek w generowanym kodzie | średnio 19,7% nazw nie istnieje | Spracklen i in., USENIX Security 2025 |
Z tabeli wynikają dwie rzeczy, które warto zapamiętać. Nowszy model nie zawsze znaczy dokładniejszy: według karty OpenAI model o3 halucynował w pytaniach o ludzi dwa razy częściej niż starszy o1, bo częściej wypowiadał się w ogóle. I wyszukiwanie w bazie zmniejsza problem, ale go nie usuwa: narzędzia prawnicze, które szukają w prawdziwych orzeczeniach, i tak myliły się w co szóstej do co trzeciej odpowiedzi.
Czy ChatGPT halucynuje?
Tak, i OpenAI pisze o tym wprost, publikując wskaźniki halucynacji w kartach swoich modeli. W tym samym tekście z 2025 r. badacze opisali, jak popularny chatbot zapytany o tytuł doktoratu jednego z autorów podał trzy różne odpowiedzi, wszystkie błędne. Z włączonym wyszukiwaniem ChatGPT myli się rzadziej, bo opiera się na źródłach, ale wtedy błąd może przyjść razem ze źródłem: model źle streści stronę albo wybierze słabą. To samo dotyczy Gemini, Copilota i Claude.
Ile już kosztowały halucynacje AI?
Na tyle dużo, że powstała osobna baza. Prawnik i badacz Damien Charlotin zebrał do 16 października 2026 r. 2199 decyzji sądów, w których pojawiły się zmyślone przez AI orzeczenia albo cytaty, w tym 6 z Polski. Kilka spraw, które dobrze pokazują skalę:
- Naczelny Sąd Administracyjny, 27 sierpnia 2026 r. W postanowieniu I OSK 935/26 NSA uznał, że błędne tezy skargi kasacyjnej „stanowią rezultat tzw. halucynacji AI”, a dopuszczenie ich do pisma bez sprawdzenia kazał oceniać „w kategoriach rażącego niedbalstwa”. Skarga powoływała się m.in. na ustawę, która nie istnieje.
- Przetarg drogowy w Małopolsce, 2025 r. Krajowa Izba Odwoławcza (KIO 3347/25) wykluczyła wykonawcę z przetargu na utrzymanie dróg wojewódzkich, bo w wyjaśnieniach ceny cytował interpretacje podatkowe, które nie istniały. Izba zaznaczyła, że powodem nie było samo użycie AI, tylko nierzetelne informacje.
- Mata v. Avianca, Nowy Jork, 22 czerwca 2023 r. Sąd ukarał prawników grzywną 5000 USD za pismo z orzeczeniami wymyślonymi przez ChatGPT. To jedna z pierwszych głośnych spraw tego typu.
- Deloitte, Australia, 2025 r. Raport dla rządu za ok. 440 tys. dolarów australijskich zawierał nieistniejące przypisy. Firma zwróciła część wynagrodzenia, według przesłuchania w Senacie prawie 98 tys. AUD.
- Air Canada, luty 2024 r. Chatbot linii podał klientowi błędne zasady zwrotu, a trybunał nakazał zapłatę 812,02 CAD. Argument, że chatbot odpowiada sam za siebie, trybunał odrzucił.
- Chicago Sun-Times, maj 2025 r. W dodatku z listą książek na lato 10 z 15 tytułów nie istniało. Autor przyznał, że przedrukował listę wygenerowaną przez AI bez sprawdzenia.
We wszystkich tych sprawach odpowiedzialność poniósł człowiek albo firma, nie model. Unijny AI Act nie używa słowa „halucynacja”, ale od systemów wysokiego ryzyka wymaga odpowiedniego poziomu dokładności (art. 15). Dla firmy praktyczny wniosek jest prosty: to, co AI napisze w Twoim imieniu, jest Twoim tekstem.
Jak ograniczyć halucynacje w firmie?
Halucynacji nie da się dziś całkowicie wyeliminować, ale da się zbudować system, w którym zmyślenie nie przejdzie dalej. Każdy z tych sposobów działa osobno, a najlepiej razem:
- Źródło w kontekście zamiast pamięci modelu. Model odpowiada na podstawie dokumentów, które mu podajesz (cennik, regulamin, umowy), a nie tego, co „pamięta”. Tak działa RAG, czyli wyszukiwanie fragmentów dokumentów przed odpowiedzią.
- Cytuj albo się wstrzymaj. Każda odpowiedź ma przypis do konkretnego dokumentu. Jeśli przypisu nie ma, system odpowiada „nie wiem” i przekazuje sprawę człowiekowi. To reguła, którą stosujemy w automatyzacji back-office. Możesz to sprawdzić u źródła: nasz serwer MCP zapytany o „cytuj” zwraca dokładnie to zdanie z opisu usługi.
- Prawo do „nie wiem”. W naszym teście dwa modele, które wymyśliły bibliografię, przestały to robić po jednym zdaniu w instrukcji: „jeśli nie możesz potwierdzić, napisz, że nie wiesz”. Ale instrukcja to prośba, nie blokada. Model zwykle się stosuje, nie musi.
- Drugi model jako recenzent. Jeden model pisze, drugi sprawdza tekst ze źródłami przed publikacją. Tak budujemy pipeline w usłudze automatycznych treści i wideo AI.
- Człowiek przy decyzjach, które kosztują. Faktura, oferta, pismo do sądu albo urzędu, treść medyczna: tu podpisuje człowiek, który sprawdził źródła.
Zanim opublikujesz tekst napisany z pomocą AI
- Każda liczba, data i nazwa ma źródło, które otworzyłeś. Nie wystarczy, że link działa.
- Przypisy i DOI: tytuł, autorzy i rok zgadzają się z tym, co jest pod linkiem.
- Przepisy: sprawdzone w ISAP albo Dzienniku Ustaw, w aktualnym brzmieniu.
- Cytaty: zdanie naprawdę występuje w źródle, słowo w słowo.
- „Teraz”, „obecnie”, „najnowszy”: sprawdź, czy to nie stan sprzed roku.
- Treści regulowane (zdrowie, prawo, finanse) czyta przed publikacją specjalista.
Skąd się wzięło słowo „halucynacja” w AI?
Z badań nad obrazem, i początkowo w dobrym znaczeniu. W 2000 r. Simon Baker i Takeo Kanade opisali metodę powiększania zdjęć twarzy, w której brakujące piksele są „w praktyce halucynowane”, czyli rozsądnie dopowiadane. W 2015 r. Andrej Karpathy użył tego słowa już w dzisiejszym sensie: model „wyhalucynował” adres strony, który nie istnieje. W 2023 r. „hallucinate” zostało słowem roku słownika Cambridge.
Termin bywa krytykowany, bo sugeruje, że model coś „widzi” albo „przeżywa”. Część badaczy woli słowo „konfabulacja”: model wypełnia luki tekstem, który pasuje do reszty, tak jak człowiek, który nie wie, że nie pamięta. Zespół z Oksfordu opisał w Nature metodę wykrywania takich konfabulacji po tym, że przy kolejnych próbach model odpowiada różnie. Widzieliśmy to w naszym teście: ten sam model podawał przy każdym pytaniu innego prezesa tej samej nieistniejącej firmy.
Najczęstsze pytania
Czy halucynacje AI da się całkowicie wyeliminować?
Dziś nie. Da się je mocno ograniczyć: źródło w kontekście, wymóg cytatu, prawo do odpowiedzi „nie wiem” i człowiek przy ważnych decyzjach. Celem jest system, w którym zmyślenie nie przejdzie dalej, a nie model, który nigdy się nie myli.
Czym halucynacja różni się od zwykłego błędu?
Halucynacja to błąd podany tonem pewności i często z wymyślonymi szczegółami, które mają go uwiarygodnić: nazwiskiem, numerem, przypisem. Zwykły błąd to np. źle przepisana liczba ze źródła. W praktyce różnica jest mniej ważna niż skutek: oba trzeba wyłapać przed publikacją.
Czy płatne modele halucynują mniej?
Nie zawsze. W rankingach różnice między modelami są duże, ale nie układają się według ceny ani daty premiery. Ważniejsze od wyboru modelu jest to, czy model dostaje źródła i czy może odpowiedzieć „nie wiem”.
Czy wyszukiwanie w sieci chroni przed halucynacjami?
Pomaga, bo model opiera się na stronach, a nie na pamięci. Nie chroni całkiem: model może źle streścić stronę, wybrać słabe źródło albo połączyć dwie sprzeczne informacje. Dlatego przy ważnych faktach i tak otwierasz źródło.
Jak sprawdzić, czy AI nie zmyśliło źródła?
Otwórz link albo DOI i porównaj tytuł, autorów i rok z tym, co podał model. Potem znajdź w źródle zdanie, które ma potwierdzać tezę. Jeśli go nie ma, nie cytuj, nawet jeśli link działa.
Czy halucynacje są groźne dla agentów AI?
Bardziej niż dla czatu, bo agent AI nie tylko pisze, ale też działa w systemach. Zmyślony numer zamówienia w odpowiedzi to błąd w tekście, a w działaniu agenta to błędna operacja. Dlatego agent ma punkty kontrolne i podpis człowieka przed krokami nieodwracalnymi. Drugie ryzyko, o którym trzeba pamiętać przy agentach, to prompt injection, czyli obce polecenia ukryte w treści, którą agent czyta.
Jak wdrożyć AI w firmie, żeby nie zmyślało?
Jeśli Twoja firma odpowiada klientom na podstawie dokumentów (umowy, cenniki, procedury, faktury), to dokładnie to budujemy: asystenta, który odpowiada z przypisem do dokumentu albo mówi, że nie wie, i zostawia człowiekowi decyzje z konsekwencjami. Opisz jeden proces, a powiemy, czy AI ma w nim sens: automatyzacja back-office, kontakt.
Stan na 16 października 2026 r. Test modeli powtarzamy co kwartał i aktualizujemy wyniki w tym haśle.
Źródła
- OpenAI, Why language models hallucinate, 5.09.2025, i Kalai i in., arXiv 2509.04664, 4.09.2025.
- OpenAI, karta modeli o3 i o4-mini, 16.04.2025.
- Vectara, Hallucination Leaderboard, stan 22.09.2026.
- Dahl i in., Large Legal Fictions, Journal of Legal Analysis, 2024; Magesh i in., Hallucination-Free?, 30.05.2024.
- Spracklen i in., We Have a Package for You!, USENIX Security 2025.
- Damien Charlotin, AI Hallucination Cases, stan 16.10.2026.
- NSA, postanowienie I OSK 935/26, 27.08.2026.
- Prawo.pl, uzasadnienie wyroku KIO 3347/25, 12.12.2025.
- Mata v. Avianca, 22-cv-1461 (PKC), Opinion and Order on Sanctions, 22.06.2023.
- The Guardian, Deloitte to pay money back, 6.10.2025.
- Civil Resolution Tribunal, Moffatt v. Air Canada, 2024 BCCRT 149, 14.02.2024.
- NPR, Fake summer reading list, 20.05.2025.
- noyb, skarga na OpenAI, 20.03.2025.
- Ahrefs, AI Overview brand visibility factors, 26.05.2025.
- Baker i Kanade, Hallucinating Faces, 2000; Karpathy, The Unreasonable Effectiveness of RNNs, 21.05.2015; Cambridge Dictionary, słowo roku 2023, 15.11.2023.
- Farquhar i in., Detecting hallucinations in large language models using semantic entropy, Nature 630, 2024.
- Test WELES, 16.10.2026: 4 modele przez OpenRouter, bez wyszukiwania; pytania, surowe odpowiedzi i sprawdzenie DOI w Crossref udostępniamy na prośbę.