Embedding w 30 sekund
- Co dokładnie dostajesz: listę kilkuset do kilku tysięcy liczb (wektor) dla każdego kawałka tekstu, obrazu albo dźwięku.
- Dlaczego to się przydaje: podobne znaczenie daje podobne liczby, więc model może je porównywać matematycznie, bez znajomości wspólnych słów.
- Gdzie to mieszka: embedding to sam wektor. Miejscem, gdzie się go przechowuje i przeszukuje, jest baza wektorowa.
Jak embedding zamienia tekst na liczby?
Model embeddingowy czyta kawałek tekstu i na wyjściu podaje wektor, czyli uporządkowaną listę liczb. Każda liczba sama w sobie nic nie znaczy - dopiero cały układ, porównany z układem innego wektora, pokazuje, jak blisko są sobie dwa znaczenia. Po polsku bywa to nazywane „osadzeniem”, bo tekst zostaje osadzony w przestrzeni liczb: stąd pełna nazwa hasła, embedding (osadzenie).
Sam model nie wymyśla tych liczb od zera przy każdym zapytaniu. Jest wcześniej wytrenowany na ogromnej liczbie tekstów, a trening polega na dopasowywaniu wektorów tak, żeby słowa i frazy, które pojawiają się w podobnych kontekstach, lądowały blisko siebie. Ten pomysł nie jest nowy: w 2013 r. Tomas Mikolov z zespołem w Google opisali word2vec, jeden z pierwszych skutecznych sposobów na zamianę słów na wektory. W tym samym roku Mikolov z innymi współautorami (Microsoft Research) pokazali, że te wektory oddają też relacje między słowami: wektor „król” minus „mężczyzna” plus „kobieta” wypadał blisko wektora „królowa”. Dzisiejsze modele (m.in. modele OpenAI i Google oraz otwarte modele z Hugging Face) robią to samo dla całych zdań i akapitów, nie tylko pojedynczych słów, i biorą pod uwagę kontekst, w którym słowo się pojawiło.
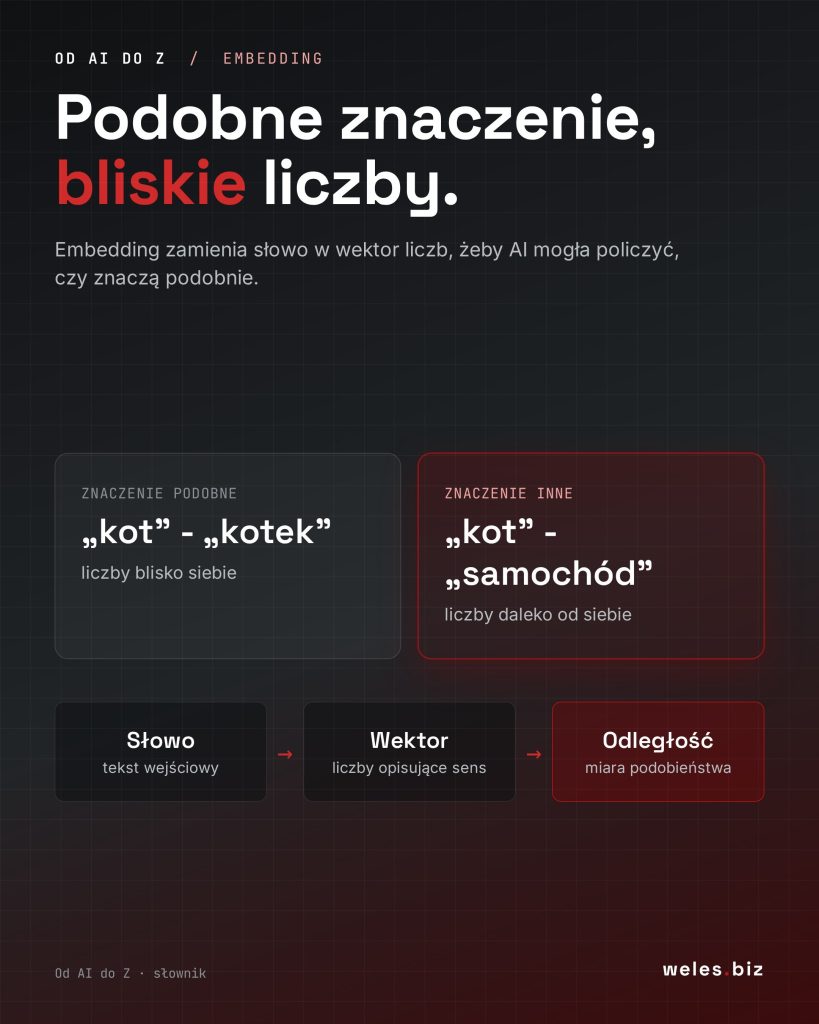
Wektor, który dostajesz na wyjściu, ma zawsze tę samą długość dla danego modelu. Model OpenAI text-embedding-3-small zapisuje każdy fragment jako wektor 1536 liczb, większy text-embedding-3-large domyślnie jako 3072 liczby. Więcej wymiarów zwykle oznacza dokładniejszy opis znaczenia, ale też więcej miejsca do przechowania i dłuższe porównywanie. Oba modele OpenAI dają też możliwość obniżenia liczby wymiarów bez ponownego trenowania, jeśli dokładność nie jest priorytetem.
Czym embedding różni się od bazy wektorowej i od RAG?
To trzy różne rzeczy, które często występują razem, dlatego łatwo je pomylić. Embedding to jeden wektor, czyli lista liczb, opisujący jeden fragment danych. Baza wektorowa to magazyn, w którym te wektory się zapisuje i przeszukuje - mechanizm przeszukiwania i rodzaje baz opisujemy w haśle baza wektorowa, tutaj nie powtarzamy tej treści. RAG to z kolei cały proces: model najpierw szuka w bazie wektorowej fragmentów podobnych do pytania, a potem odpowiada na podstawie tego, co znalazł - mechanizm RAG, z regułą „cytuj albo się wstrzymaj”, jest tematem hasła RAG.
| Pojęcie | Co to jest | Pytanie, na które odpowiada |
|---|---|---|
| Embedding | wektor liczb opisujący jeden fragment tekstu, obrazu albo dźwięku | jak zapisać znaczenie tego kawałka danych jako liczby? |
| Baza wektorowa | magazyn, który przechowuje wektory i szuka najbliższych | gdzie zapisać miliony takich wektorów i jak szybko je przeszukać? |
| RAG | proces: szukaj, a potem odpowiadaj na podstawie znalezionego | jak zbudować z tego chatbota, który odpowiada na podstawie dokumentów? |
Bez embeddingu nie ma czego wpisać do bazy wektorowej, a bez bazy wektorowej RAG nie ma gdzie szukać. To jeden mechanizm rozbity na trzy warstwy, nie trzy konkurujące technologie.
Jakie są modele embeddingowe i ile kosztuje zrobienie embeddingu?
Modele embeddingowe różnią się twórcą, liczbą wymiarów wektora i ceną. Najczęściej spotykane w polskich wdrożeniach modele OpenAI, stan cennika na 22 października 2026 r.:
| Model | Wymiary wektora | Cena za 1 mln tokenów |
|---|---|---|
| text-embedding-3-small | 1536 (domyślnie) | 0,02 USD |
| text-embedding-3-large | 3072 (domyślnie) | 0,13 USD |
| text-embedding-ada-002 | 1536 | 0,10 USD |
Te ceny są rzędu wielkości mniejsze niż koszt generowania odpowiedzi przez model językowy, bo embedding tylko czyta tekst i oddaje liczby - nie pisze niczego nowego, więc nie ma kosztu tokenów wyjściowych. Jeśli przyjąć, że jeden fragment dokumentu w bazie wektorowej to zwykle kilkaset tokenów (patrz hasło baza wektorowa o liczbie fragmentów na dokument), to zamiana nawet kilkudziesięciu tysięcy fragmentów na wektory, nawet w najdroższym z trzech modeli z tabeli wyżej, kosztuje rząd dolarów, nie setek czy tysięcy. Oprócz modeli OpenAI działają też modele open source (np. z rodziny BGE, E5, Nomic Embed) - można je uruchomić na własnym serwerze bez opłaty za każde zapytanie, kosztem własnej infrastruktury.
Czy do polskiego tekstu trzeba specjalnego modelu embeddingowego?
Niekoniecznie, ale warto to sprawdzić, a nie zgadywać. Większość popularnych modeli embeddingowych (w tym modele OpenAI) jest wielojęzyczna i radzi sobie z polskim, choć zwykle słabiej niż z angielskim. Do sprawdzenia, jak konkretny model wypada na polskim tekście, służy PIRB (Polish Information Retrieval Benchmark): publiczny zestaw 41 zadań wyszukiwania w języku polskim (prawo, medycyna, biznes i inne), opracowany przez Sławomira Dadasa, Michała Perełkiewicza i Rafała Poświatę z Ośrodka Przetwarzania Informacji (OPI PIB), opublikowany na konferencji LREC-COLING 2024. Porównuje ponad 20 modeli, zarówno zamkniętych, jak i open source, specjalnie na polskich danych, podczas gdy ogólne rankingi modeli embeddingowych opierają się głównie na tekstach angielskich.
Praktyczna zasada: jeśli dokumenty firmy są głównie po polsku i zawierają specyficzne słownictwo (nazwy produktów, terminy prawne, żargon branżowy), warto przetestować wyszukiwanie na kilku prawdziwych pytaniach klientów, zanim wybierze się model na stałe. Zmiana modelu później nie jest bezbolesna - patrz niżej.
Czego embedding nie robi?
- Embedding to nie trenowanie modelu. Zrobienie embeddingu jest jednym przejściem danych przez model, który już jest gotowy. Nic się w nim nie zmienia i niczego się nie uczy na nowo - to różni embedding od fine-tuningu, czyli donauczania modelu na własnych danych.
- Wektorów z różnych modeli nie da się porównywać. Wektor z modelu A i wektor z modelu B mogą mieć nawet tę samą liczbę wymiarów i nic to nie znaczy - każdy model ma swój własny układ przestrzeni liczb. Zmiana modelu embeddingowego wymaga przeliczenia wszystkich wektorów w bazie od nowa, nie tylko dopisania nowych. Co to oznacza dla kosztów, opisujemy w haśle baza wektorowa.
- Embedding nie pamięta kontekstu poza tym, co dostał na wejściu. Jeśli fragment dokumentu wycięto bez istotnego zdania z poprzedniego akapitu, wektor tego nie odda - nie ma dostępu do niczego, czego fizycznie nie dostał do przetworzenia.
Jak to wygląda w praktyce w firmie?
Embedding sam w sobie nie jest produktem, który firma kupuje - jest krokiem w środku większego systemu. W naszej usłudze automatyzacji księgowości i back-office ten krok stoi za chatbotem odpowiadającym na podstawie dokumentów firmy: każdy fragment faktury, umowy czy procedury trafia najpierw do modelu embeddingowego, a dopiero potem do bazy wektorowej, z której chatbot później wyciąga odpowiedzi z przypisem do źródła. Klient tego kroku nie widzi - widzi tylko odpowiedź z cytatem albo informację, że system nie znalazł podstawy do odpowiedzi.
Czy embedding jest bezpieczny dla danych firmy?
Embedding wygląda jak lista liczb bez znaczenia, ale to złudne wrażenie: wektor jest pochodną oryginalnego tekstu i w pewnych warunkach da się z niego odtworzyć spory kawałek treści wejściowej. Badacze z Cornell (Morris, Kuleshov, Shmatikov, Rush, „Text Embeddings Reveal (Almost) As Much As Text”, EMNLP 2023) pokazali metodę (vec2text), która dla krótkich tekstów (32 tokeny) odtworzyła dokładną treść w 92% przypadków, w tym pełne nazwiska osób z embeddingów notatek klinicznych. To nie jest atak teoretyczny - działał na embeddingach z realnych modeli, w tym z modelu OpenAI.
Z tego wynika praktyczny wniosek: embeddingi dokumentów z danymi osobowymi albo tajemnicą firmy trzeba zabezpieczać tak samo, jak oryginalny tekst, a nie traktować jako bezpieczną, zanonimizowaną wersję danych. Dostęp do bazy wektorowej, szyfrowanie i umowa powierzenia przetwarzania danych z dostawcą usługi w chmurze dotyczą embeddingów równie mocno, jak dokumentów, z których powstały.
Zanim zdecydujesz się na konkretny model embeddingowy
- Sprawdź wyniki na polskim tekście, najlepiej na kilku prawdziwych pytaniach klientów, nie tylko na reputacji modelu z angielskich rankingów.
- Policz koszt dla swojej skali dokumentów - przy embeddingach to zwykle grosze, nie główny element budżetu wdrożenia.
- Sprawdź, jak dzielisz dokumenty na fragmenty, zanim policzysz wektory: embedding widzi tylko to, co dostał w jednym kawałku, a zbyt pocięty tekst gubi sens.
- Traktuj embeddingi danych osobowych jak same dane osobowe, nie jak ich bezpieczną, zanonimizowaną kopię.
Najczęstsze pytania
Czy niewielka zmiana tekstu znacząco zmienia jego embedding?
Zwykle nie. Dobre modele embeddingowe są uczone tak, żeby drobna zmiana (literówka, inna kolejność słów o tym samym sensie) dawała wektor leżący blisko oryginału. Duża zmiana wektora pojawia się dopiero, gdy zmienia się znaczenie zdania, nie jego zapis.
Czym różni się embedding od tokenizacji?
Tokenizacja dzieli tekst na mniejsze kawałki (tokeny), którymi model operuje wewnętrznie - to krok przygotowawczy, nie wynik końcowy. Embedding to wektor wynikowy, który opisuje znaczenie całego fragmentu (słowa, zdania, dokumentu) po przejściu przez model. Tokenizacja jest po drodze, embedding jest na wyjściu.
Czy można samemu zbudować model embeddingowy?
Technicznie tak, ale w praktyce rzadko ma to sens dla firmy. Trenowanie własnego modelu embeddingowego od zera wymaga ogromnej liczby danych i mocy obliczeniowej. Zdecydowanie częściej firmy używają gotowego modelu (OpenAI albo open source) i, jeśli trzeba, dostrajają go do własnego słownictwa - to już bliżej fine-tuningu niż budowy embeddingu od podstaw.
Czy embedding działa też dla obrazów i dźwięku, nie tylko tekstu?
Tak. Mechanizm jest ten sam: model zamienia obraz, fragment dźwięku albo wideo na wektor liczb w taki sposób, żeby podobna treść dawała podobne liczby. Modele takie jak CLIP potrafią nawet zamienić tekst i obraz na wektory w tej samej przestrzeni, dzięki czemu da się wyszukać zdjęcie opisem słownym.
Dokumenty firmy gotowe do zamiany na wektory?
Jeśli zastanawiasz się, czy embedding i baza wektorowa mają sens dla Twoich dokumentów, najprościej zacząć od jednego konkretnego pytania, które klienci zadają najczęściej - opisz je, a powiemy, czy potrzebny jest cały mechanizm wyszukiwania po znaczeniu, czy wystarczy coś prostszego. Szczegóły: automatyzacja księgowości i back-office, kontakt.
Stan na 22 października 2026 r. Ceny modeli embeddingowych zmieniają się, więc przed wdrożeniem warto sprawdzić aktualny cennik dostawcy.
Źródła
- Mikolov T., Chen K., Corrado G., Dean J., Efficient Estimation of Word Representations in Vector Space, arXiv 1301.3781, 16.01.2013.
- Mikolov T., Yih W., Zweig G., Linguistic Regularities in Continuous Space Word Representations, NAACL-HLT 2013 (przykład „król - mężczyzna + kobieta = królowa”).
- OpenAI, New embedding models and API updates, 25.01.2024, i dokumentacja embeddingów.
- OpenAI, cennik API, odczyt 22.10.2026.
- Dadas S., Perełkiewicz M., Poświata R., PIRB: A Comprehensive Benchmark of Polish Dense and Hybrid Text Retrieval Methods, OPI PIB, LREC-COLING 2024.
- Morris J., Kuleshov V., Shmatikov V., Rush A., Text Embeddings Reveal (Almost) As Much As Text, EMNLP 2023.
- WELES, hasła baza wektorowa i RAG; usługa automatyzacja księgowości i back-office.
To hasło dotyczy embeddingu jako sposobu reprezentacji danych w AI. W elektronice i programowaniu „embedded” oznacza coś zupełnie innego - system wbudowany w urządzenie (np. embedded system w pralce czy czujniku) - to inne, niezwiązane znaczenie tego samego angielskiego słowa.