RAG w 30 sekund
- Kiedy ma sens: przy dziesiątkach i setkach dokumentów, które się zmieniają. Przy kilku plikach wystarczy wgrać je do czatu.
- Czym różni się od fine-tuningu: fine-tuning trwale zmienia model, RAG tylko dostarcza mu kontekst na chwilę, do jednej odpowiedzi.
- Czy kończy z halucynacjami: nie. Redukuje je, ale najwięcej daje w parze z regułą „cytuj albo się wstrzymaj”.
Jak działa RAG?
RAG szuka odpowiedzi, zanim ją napisze. Pytanie użytkownika zamienia się w wektor liczb (embedding), który system porównuje z podobnie zakodowanymi fragmentami dokumentów firmy w bazie wektorowej. System wybiera kilka najbliższych fragmentów, dokłada je do zapytania i dopiero wtedy model językowy pisze odpowiedź, mając przed sobą konkretny tekst, a nie tylko to, czego nauczył się miesiące wcześniej. Nazwę i metodę w tej postaci opisał w maju 2020 r. zespół badaczy Facebook AI Research (dziś Meta) razem z University College London i New York University, w pracy „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”.
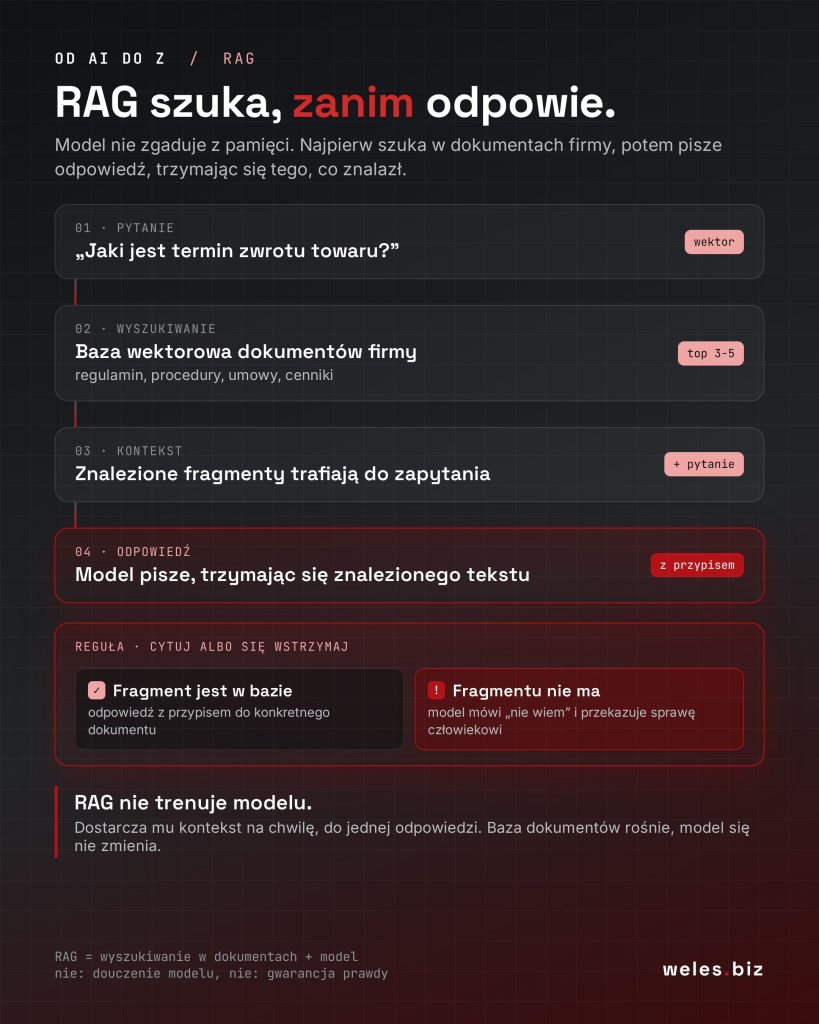
Cztery kroki powtarzają się w każdym systemie RAG: zapytanie, wyszukanie, złożenie kontekstu, odpowiedź z przypisem do źródła. Różnice między wdrożeniami dotyczą tego, jak dokumenty są podzielone na fragmenty (chunking), jaki model zamienia tekst na wektory (embedding) i czy wynik wyszukiwania jest jeszcze porządkowany przez dodatkowy model (reranking). Te trzy pojęcia opisujemy w osobnej sekcji niżej.
RAG nie trenuje modelu. Model nie zmienia się między pytaniami, a baza dokumentów może rosnąć i być aktualizowana bez dotykania samego modelu. To jest najważniejsza różnica wobec fine-tuningu, do której wracamy w sekcji o wyborze metody.
Do czego służy RAG w firmie?
Najczęstsze zastosowanie to chatbot, który odpowiada na podstawie dokumentów firmy: regulaminu, cennika, procedur, umów, instrukcji. Klient albo pracownik zadaje pytanie zwykłym językiem, a system znajduje właściwy fragment i odpowiada z odniesieniem do konkretnego dokumentu, zamiast zgadywać na podstawie tego, co model „pamięta” z internetu.
Tak działa to w naszej usłudze automatyzacji księgowości i back-office: rutynowe pytania obsługuje chatbot oparty na dokumentach klienta, a zasada brzmi „cytuj albo się wstrzymaj” - model odpowiada z przypisem do konkretnego dokumentu albo mówi, że nie wie. Punkt kontrolny człowieka zostaje tam, gdzie decyzja ma skutki finansowe lub prawne. Tę zasadę opisujemy szerzej w haśle halucynacje AI, bo to ona, nie sam RAG, domyka problem zmyślania.
Poza chatbotem RAG sprawdza się tam, gdzie trzeba przeszukać duży, zmieniający się zbiór tekstu: wyszukiwanie w bazie wiedzy pracowników, podsumowania umów przed podpisem, odpowiedzi na pytania o politykę firmy, wsparcie dla działu obsługi klienta. Wspólny mianownik: odpowiedź ma się dać zweryfikować, bo prowadzi do konkretnego miejsca w konkretnym dokumencie.
Czy RAG eliminuje halucynacje?
Nie, tylko je redukuje. To jeden z najczęściej powtarzanych mitów, bo wielu dostawców reklamuje swoje narzędzia z RAG jako „wolne od halucynacji”. Badacze ze Stanford RegLab sprawdzili to twierdzenie na popularnych komercyjnych narzędziach prawniczych z RAG (Lexis+ AI, Westlaw AI-Assisted Research) i znaleźli halucynacje w 17-33% odpowiedzi, mimo deklaracji producentów. To ta sama liczba, którą podajemy w haśle halucynacje AI w tabeli częstości błędów.
Dobrze pokazuje to sprawa linii Air Canada. Chatbot podał klientowi błędne zasady zwrotu za bilet, choć w tej samej odpowiedzi linkował do strony linii z poprawnymi. Kanadyjski trybunał uznał w lutym 2024 r., że firma odpowiada za informacje z własnego chatbota, i nakazał zapłatę. Nie wiadomo, jak ten chatbot był zbudowany, ale wniosek dla RAG jest ten sam: znalezienie właściwej strony nie gwarantuje poprawnej odpowiedzi.
Dlatego samo podłączenie dokumentów nie jest zabezpieczeniem. Potrzebna jest reguła, która każe modelowi trzymać się znalezionego tekstu i mówić „nie wiem”, gdy fragmentu nie ma albo jest niejednoznaczny - czyli „cytuj albo się wstrzymaj”. Bez niej RAG bywa tylko lepiej poinformowanym zgadywaniem.
RAG, fine-tuning czy długie okno kontekstowe - co wybrać?
Kryterium jest proste: czy problem dotyczy wiedzy, czy zachowania modelu. RAG dostarcza aktualną wiedzę z zewnątrz. Fine-tuning zmienia, jak model formułuje odpowiedzi - ton, format, styl, powtarzalne zachowanie. OpenAI w przewodniku o dokładności modeli opisuje to jako dwie osie optymalizacji i podaje przykład, w którym dodanie RAG do problemu, który był błędem formatu, a nie wiedzy, pogorszyło wynik, bo nie było to lekarstwo na właściwą przyczynę.
| RAG | Fine-tuning | Długie okno kontekstowe | |
|---|---|---|---|
| Co zmienia | nic w modelu, dostarcza kontekst na chwilę | wagi modelu, trwale | nic, tylko wkleja całość do zapytania |
| Dla jakiego problemu | brak aktualnej, firmowej wiedzy | złe formatowanie, ton, powtarzalne błędy zachowania | mały, stabilny zbiór dokumentów |
| Aktualizacja danych | dopisanie dokumentu do bazy | nowy proces uczenia | wklejenie nowej wersji dokumentu |
| Kontrola dostępu | łatwa, na poziomie wyszukiwania | trudna, wiedza jest „wtopiona” w model | trudna przy wielu użytkownikach i wielu zestawach |
| Kiedy wystarczy prościej | - | - | korpus do ok. 200 tys. tokenów, rzadkie zmiany |
Granicę dla długiego kontekstu podaje Anthropic w opisie własnej metody Contextual Retrieval: korpusy do około 200 tysięcy tokenów (to kilkaset stron) mogą obejść się bez RAG, jeśli wystarczy wkleić je do zapytania. Powyżej tego progu, albo gdy liczy się koszt każdego zapytania, osobne uprawnienia dla każdego użytkownika czy częsta aktualizacja danych, RAG wygrywa. W tym samym materiale Anthropic pokazuje, że dodanie krótkiego opisu kontekstu do każdego fragmentu przed jego zakodowaniem zmniejszyło liczbę nietrafionych wyszukiwań o 35%, a razem z dodatkowym wyszukiwaniem słów kluczowych i rerankingiem o 67% względem najprostszego wariantu.
Z czego składa się system RAG?
Trzy pojęcia wracają w każdym opisie RAG, więc warto je rozróżnić:
- Chunking - podział długich dokumentów na mniejsze fragmenty, zwykle kilkaset do tysiąca znaków, czasem z niewielkim zakładem między sąsiednimi kawałkami. Zły podział (np. rozcięcie reguły od wyjątku w połowie) jest jedną z najczęstszych przyczyn, dla których system nie znajduje właściwej odpowiedzi, mimo że ta jest w bazie.
- Embedding - zamiana fragmentu tekstu na wektor liczb w taki sposób, że podobne znaczeniowo fragmenty mają podobne wektory. To właśnie po podobieństwie wektorów system wyszukuje odpowiedzi, nie po dokładnych słowach.
- Baza wektorowa - magazyn, w którym te wektory są przechowywane i szybko porównywane z wektorem pytania. To osobny temat, który opiszemy w kolejnym haśle słownika.
Część systemów dodaje jeszcze reranking: po pierwszym wyszukaniu kilkudziesięciu kandydatów, drugi, dokładniejszy model ocenia je ponownie i wybiera te, które faktycznie trafiają w sens pytania. W teście Anthropic opisanym wyżej był to ostatni krok: bez rerankingu liczba nietrafionych wyszukiwań spadła o 49%, z nim o 67%.
Czym RAG różni się od agenta AI i MCP?
RAG to technika wyszukiwania, nie system decyzyjny. Agent AI to program, w którym model sam wybiera kolejne kroki zadania - i RAG może być jednym z narzędzi, po które agent sięga, gdy potrzebuje sprawdzić coś w dokumentach, zamiast działać na pamięć. Chatbot z RAG, który tylko odpowiada na pytania, agentem nie jest: nie planuje wielu kroków i nie wywołuje innych systemów.
MCP (Model Context Protocol) to z kolei sposób podłączenia narzędzi do modelu, a nie metoda wyszukiwania. Jedno nie zastępuje drugiego: wyszukiwarka dokumentów oparta na RAG może być jednym z narzędzi wystawionych przez serwer MCP.
Co może pójść źle w systemie RAG?
Badacze z Deakin University opisali na podstawie trzech wdrożeń siedem punktów awarii systemu RAG. Cztery pierwsze z ich listy:
- Odpowiedzi w ogóle nie ma w bazie - system i tak coś odpowie, jeśli nie ma reguły „cytuj albo się wstrzymaj”.
- Właściwy fragment jest w bazie, ale wyszukiwanie go nie znajduje - zwykle przez zły chunking albo słaby model embeddingów.
- Fragment jest znaleziony, ale nie zmieścił się w oknie kontekstowym razem z innymi wynikami.
- Model ma dobry fragment, ale źle go wykorzystuje - streszcza nieprecyzyjnie albo miesza go z inną informacją.
Do tego dochodzi ryzyko, o którym łatwo zapomnieć poza samą jakością odpowiedzi: dokument jako wektor ataku. Jeśli do bazy trafia treść z zewnątrz (mail, strona, plik od klienta), ktoś może w niej ukryć instrukcję dla modelu - mechanizm opisujemy w haśle prompt injection. Dlatego dane trafiające do bazy wektorowej wymagają tej samej kontroli dostępu, co oryginalne dokumenty: pracownik nie powinien przez chatbota zobaczyć więcej, niż zobaczyłby w systemie firmy, a dane osobowe w bazie wektorowej podlegają tym samym zasadom RODO, co ich oryginały.
Zanim wdrożysz RAG na dokumentach firmy
- Reguła „cytuj albo się wstrzymaj” wpisana w instrukcję modelu, nie licząc na dobrą wolę.
- Kontrola dostępu do bazy wektorowej taka sama, jak do oryginalnych dokumentów.
- Dokumenty od zewnętrznych nadawców traktowane jako potencjalnie niebezpieczna treść, nie jako czyste dane.
- Test na pytaniach bez odpowiedzi w bazie - sprawdzenie, czy system umie powiedzieć „nie wiem”.
- Punkt kontrolny człowieka przy odpowiedziach ze skutkiem finansowym lub prawnym.
Ile kosztuje i jak długo trwa wdrożenie RAG?
Szczerze: nie znaleźliśmy żadnych wiarygodnych, branżowych danych o typowym koszcie czy czasie budowy systemu RAG - liczby krążące w sieci nie mają sprawdzalnego źródła, więc ich tu nie powtarzamy. Możemy podać tylko naszą własną praktykę z innego typu projektu: w usłudze automatyzacji back-office pierwszy typ dokumentu wdrażamy zwykle w 2-4 tygodnie. To nie jest norma rynkowa, tylko punkt odniesienia z jednego konkretnego zakresu prac.
Co realnie wpływa na koszt: liczba i różnorodność dokumentów, czy trzeba je najpierw odczytać z PDF-ów i skanów (OCR), jak często baza się zmienia, jak wysokie są wymagania bezpieczeństwa i czy model ma działać lokalnie, zamiast przez API dostawcy.
Jak zbudować system RAG?
- Wgranie plików do czatu. ChatGPT, Claude czy Gemini pozwalają dołączyć kilka albo kilkadziesiąt dokumentów do rozmowy czy projektu. Dla małej, rzadko zmieniającej się liczby plików to najszybsza droga, bez budowania niczego.
- Narzędzia no-code i low-code. Platformy typu n8n albo firmowe systemy mają gotowe moduły do podłączenia bazy dokumentów do modelu. Szkielet procesu ustala człowiek, a wyszukiwanie i odpowiedź robi model.
- Własny kod. Pełna kontrola nad chunkingiem, modelem embeddingów, bazą wektorową i regułami odpowiedzi. Tak budujemy RAG w ramach automatyzacji back-office, gdzie liczy się kontrola dostępu i cytowanie źródeł.
Niezależnie od drogi, pierwsza decyzja nie jest techniczna: które dokumenty trafiają do bazy, kto może o co pytać i co system ma zrobić, gdy nie znajdzie odpowiedzi. Technikę dobiera się do tej decyzji, nie odwrotnie.
Najczęstsze pytania
Czy RAG to trenowanie modelu na danych firmy?
Nie. Model nie zmienia się ani nie „uczy się” danych firmy. RAG dokłada do każdego zapytania fragmenty dokumentów znalezione w bazie, a po odpowiedzi wszystko wraca do punktu wyjścia. Trwałą zmianę modelu daje fine-tuning, czyli inna metoda.
Czym RAG różni się od długiego okna kontekstowego?
Długie okno kontekstowe wkleja całość dokumentów do każdego zapytania, co wystarcza przy małym, stabilnym zbiorze. RAG wyszukuje tylko potrzebne fragmenty, więc skaluje się do tysięcy dokumentów, łatwiej pilnuje, kto do czego ma dostęp, i nie wymaga przeładowania całości przy każdej zmianie.
Czy potrzebuję bazy wektorowej dla dziesięciu dokumentów?
Zwykle nie. Przy kilku, kilkunastu dokumentach prostsze jest wgranie ich bezpośrednio do rozmowy z modelem albo do długiego okna kontekstowego. Baza wektorowa i cały system RAG zaczynają się opłacać przy dziesiątkach, setkach i tysiącach dokumentów albo przy danych, które często się zmieniają.
Czy RAG jest bezpieczny dla danych firmy?
Zależy, jak zbudowany. Baza wektorowa z dokumentami firmowymi wymaga tej samej kontroli dostępu i tych samych zasad RODO, co oryginalne pliki, a treści z zewnątrz trzeba traktować jako potencjalny wektor ataku (prompt injection). RAG sam z siebie nie jest ani bezpieczniejszy, ani bardziej ryzykowny niż inne systemy na danych firmy - zależy od tego, kto go zbudował i jak.
Jak nazywa się RAG po polsku?
„Generowanie wspomagane wyszukiwaniem”. W polskiej, tłumaczonej maszynowo dokumentacji Microsoft Learn jest „generacja wspomagana wyszukiwaniem”, gdzie indziej bywa też „wspomagana pobieraniem”. Ustalonej nazwy nie ma, a w praktyce i w wyszukiwarce wygrywa skrót RAG, zwykle nieodmieniany („systemy RAG”), czasem z końcówką („w RAG-u”).
RAG na dokumentach Twojej firmy: od czego zacząć?
Jeśli klienci albo pracownicy co tydzień pytają o to samo, a odpowiedź jest zapisana w regulaminie, cenniku czy procedurze, to dokładnie ten przypadek, dla którego robimy RAG na dokumentach: chatbot, który cytuje źródło albo mówi, że nie wie, i zostawia trudniejsze decyzje człowiekowi. Czasem po rozmowie wychodzi, że wystarczy mniej niż RAG - zwykła wyszukiwarka w dokumentach albo FAQ. Opisz, czego ludzie najczęściej pytają: automatyzacja księgowości i back-office, kontakt.
Stan na 16 października 2026 r. Modele i narzędzia do RAG zmieniają się szybko, więc aktualizujemy to hasło co kwartał.
Źródła
- Lewis P. i in., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv 2005.11401, 22.05.2020 (Facebook AI Research, University College London; NeurIPS 2020).
- Magesh V. i in., Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford RegLab/HAI, arXiv 2405.20362, 30.05.2024.
- Anthropic, Introducing Contextual Retrieval, 19.09.2024.
- OpenAI, Optimizing LLM accuracy.
- Barnett S. i in., Seven Failure Points When Engineering a RAG System, arXiv 2401.05856, 11.01.2024.
- Civil Resolution Tribunal, Moffatt v. Air Canada, 2024 BCCRT 149, 14.02.2024.
- AWS, definicja RAG; IBM, definicja RAG; Microsoft Learn, Retrieval Augmented Generation (RAG) in Azure AI Search.
- WELES, usługa automatyzacja księgowości i back-office (opis chatbota na dokumentach i reguły „cytuj albo się wstrzymaj”).