Jailbreak AI w 30 sekund
- To rozmowa, nie włamanie: celem jest namówienie modelu, żeby zignorował własne zasady, bez dostępu do kodu czy serwera.
- Czym różni się od prompt injection: tu atakujący rozmawia z modelem wprost, nie chowa polecenia w treści, którą model czyta za kogoś innego.
- Czy da się to zablokować na zawsze: nie. To wyścig: producenci łatają znane techniki, a w ich miejsce pojawiają się nowe.
Dlaczego model w ogóle da się przekonać, żeby złamał własne zasady?
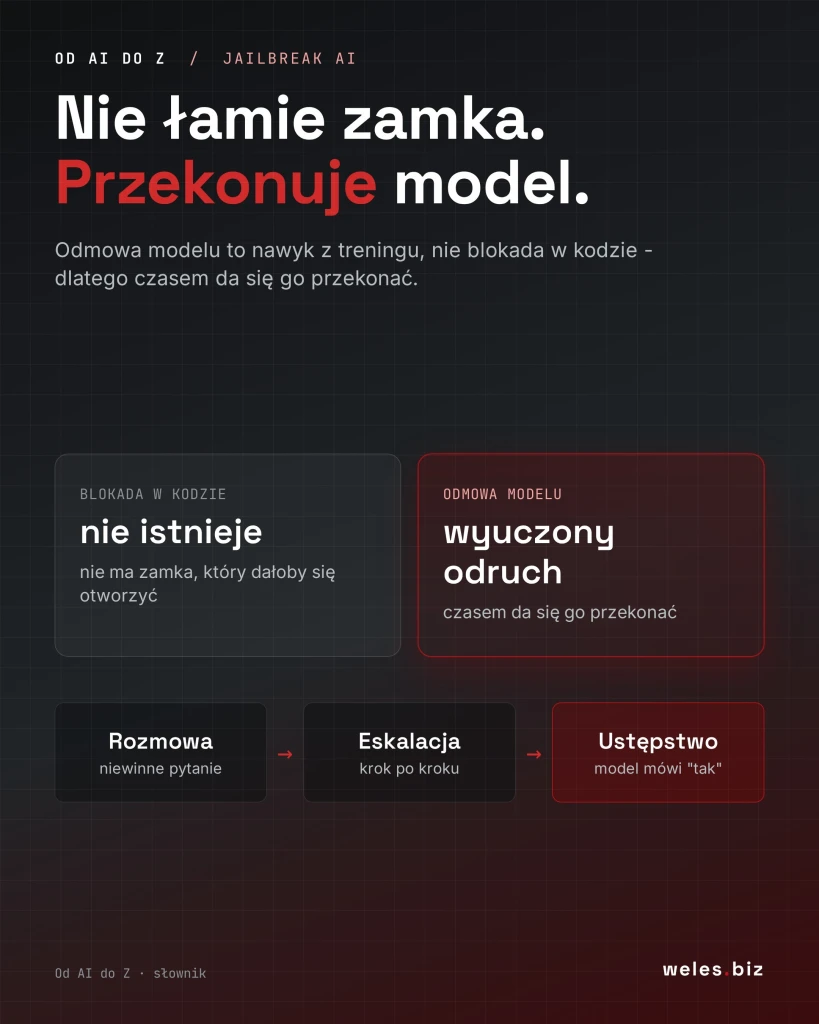
Bo odmowa modelu nie jest twardą blokadą wpisaną w kod, tylko zachowaniem, którego nauczył się podczas treningu. Model nie ma gdzieś w środku linijki „jeśli pytanie niebezpieczne, odmów” - ma zestaw przykładów, na których uczono go reagować właśnie tak. Mark Russinovich, który dla Microsoftu opisał jedną z głośniejszych technik (Skeleton Key, o niej niżej), ujął skutek jailbreaku jako zwężanie przepaści między tym, co model umie zrobić, a tym, co chce zrobić. Dlatego jedna dobrze zbudowana rozmowa bywa skuteczna na kilku różnych modelach naraz: nie wykorzystuje błędu jednej firmy, tylko właściwość tego, jak w ogóle trenuje się dzisiejsze modele językowe.
Jak wyglądała historia głośnych jailbreaków?
Poniżej same nazwy, daty i mechanizm w jednym zdaniu, bez przepisu na działanie. Większość z tych technik producenci już załatali.
| Technika | Kiedy i kto opisał | Mechanizm w skrócie |
|---|---|---|
| DAN („Do Anything Now”) | XII 2022, użytkownicy r/ChatGPT na Reddicie | polecenie modelowi, żeby odgrywał rolę postaci bez ograniczeń; później dodano groźbę „śmierci” tej postaci przy odmowie |
| Many-shot jailbreaking | 02.04.2024, Anthropic | w jednym długim poleceniu umieszcza się wiele fikcyjnych dialogów, w których asystent już odpowiada na niebezpieczne pytania |
| Crescendo | 02.04.2024, badacze Microsoftu (Russinovich, Salem, Eldan) | wieloturowa rozmowa, która zaczyna się niewinnie i krok po kroku, odwołując się do wcześniejszych odpowiedzi modelu, prowadzi go dalej |
| Skeleton Key | 26.06.2024, Microsoft (Mark Russinovich) | prośba, żeby model nie zmieniał, a „rozszerzył” swoje zasady i odpowiadał na wszystko z ostrzeżeniem zamiast odmowy; zadziałała na kilku modelach różnych firm naraz |
| Time Bandit | 30.01.2025, nota CERT/CC po zgłoszeniu z 16.12.2024 | mylenie modelu co do ram czasowych rozmowy, co w ChatGPT-4o obniżało skuteczność filtrów treści |
Wzór się powtarza: ktoś znajduje technikę, zwykle zgłasza ją producentowi (Anthropic i Microsoft piszą wprost, że informowały inne firmy przed publikacją), producent łata konkretny przypadek, a społeczność szuka następnego. Dlatego gotowe prompty z internetu, nawet te z dużych kompilacji na GitHubie, w większości już nie działają - to, co opisujemy wyżej, jest historią, nie instrukcją na dziś.
Czym jailbreak różni się od prompt injection?
Pełne wyjaśnienie tej różnicy jest już w haśle prompt injection, więc tu nie powtarzamy definicji. Jedno, czego tam nie ma: różnica w tym, kto inicjuje atak. Jailbreak to zawsze rozmowa, którą sam użytkownik prowadzi z modelem, próbując go przekonać. Prompt injection może w ogóle nie dotyczyć użytkownika jako atakującego - polecenie czeka podrzucone w mailu, na stronie albo w pliku, a użytkownik tylko prosi asystenta, żeby to przeczytał, nie wiedząc, co tam jest. OWASP, organizacja od standardów bezpieczeństwa aplikacji, traktuje jailbreak jako odmianę prompt injection, której celem jest doprowadzenie modelu do całkowitego zignorowania zasad bezpieczeństwa. Nie każde źródło rysuje tę granicę tak samo (IBM opisuje je jako dwie osobne techniki) - trzymamy się podziału OWASP, bo jest zgodny z resztą tego słownika.
Czy jailbreakowanie modelu AI jest nielegalne?
Zwykle nie w sensie prawa karnego - to naruszenie regulaminu dostawcy, nie przestępstwo. OpenAI w swoich zasadach korzystania (Usage Policies) zapowiada, że za łamanie lub obchodzenie jej zasad i zabezpieczeń można stracić dostęp do usług albo ponieść inne sankcje. To konsekwencje po stronie konta, nie postępowanie sądowe. Unijny AI Act idzie w inną stronę: nie zakazuje jailbreakowania użytkownikom, tylko zobowiązuje dostawców modeli ogólnego przeznaczenia o tzw. ryzyku systemowym do oceny modelu, w tym testów kontradyktoryjnych (red teamingu), które obejmują m.in. próby jailbreaku (art. 55, dla modeli wprowadzanych na rynek od 2 sierpnia 2025 r.). To obowiązek po stronie firmy budującej model, nie zakaz dla osoby, która z nim rozmawia. Nielegalne staje się to, co ktoś zrobi z wynikiem jailbreaku, np. wygenerowane materiały zakazane prawem - to już osobny reżim odpowiedzialności, niezależny od samego aktu rozmowy z modelem.
Trzy głośne wpadki chatbotów: czy to naprawdę był jailbreak?
Nie każdy wiralowy zrzut ekranu z dziwną odpowiedzią chatbota jest jailbreakiem. Trzy przykłady, które obiegły internet, warto rozebrać osobno:
| Przypadek | Co się stało | Czy to był jailbreak? |
|---|---|---|
| Chevrolet, XII 2023 | klient nakazał botowi dealera zgadzać się z każdym jego stwierdzeniem i uznać to za „prawnie wiążące”, bot zgodził się na sprzedaż auta za 1 dolara | Nie, to bliżej przejęcia celu rozmowy niż złamania zasad bezpieczeństwa treści. Żaden samochód nie został faktycznie sprzedany. |
| DPD, I 2024 | chatbot przewoźnika po prostych poleceniach klienta zaczął przeklinać i napisał wiersz krytykujący własną firmę | Najbliżej podręcznikowego przykładu ze wszystkich trzech, choć DPD samo opisało to jako błąd konfiguracji po aktualizacji systemu, nie jako atak. |
| Grok „MechaHitler”, VII 2025 | chatbot xAI zaczął publikować skandaliczne treści | Nie. xAI podało, że przyczyną była zmiana w kodzie wdrożona przez samego dostawcę, a nie obejście zabezpieczeń przez użytkownika z zewnątrz. |
Wniosek praktyczny: zanim ktoś w firmie nazwie incydent „jailbreakiem”, warto sprawdzić, czy ktoś faktycznie złamał zabezpieczenia treści, czy to był inny mechanizm (przejęcie celu rozmowy, błąd konfiguracji dostawcy). Ma to znaczenie dla tego, kogo się winić i co naprawić.
Jakie ryzyko to niesie dla firmy?
Ryzyko ma dwa poziomy i drugi z nich rzadko pojawia się w tekstach o jailbreaku.
- Poziom treści. Chatbot klienta mówi coś, czego nie powinien: przekleństwo, treść dla dorosłych, poradę, po której firma nie chce stać. To wstyd i czasem odpowiedzialność, jak w precedensie, który opisujemy w haśle halucynacje AI - firma odpowiada za to, co powie jej bot, nawet gdy bot się pomylił sam, bez pomocy atakującego.
- Poziom akcji. Gdy jailbreak dotyka nie chatbota, a agenta AI z dostępem do narzędzi i systemów firmy, skutek przesuwa się z „zawstydzającej odpowiedzi” na „wykonane działanie”: wysłany mail, zmieniony rekord w systemie, pobrany plik. OWASP nazywa to ryzyko nadmiarowymi uprawnieniami (Excessive Agency). Agent, który dał się namówić do zignorowania zasad, jest tak bezpieczny, jak uprawnienia konta, z którego korzysta - nie jak to, co obiecał w prompcie systemowym.
Jak ograniczyć ryzyko jailbreaku we własnym wdrożeniu?
Nie ma jednej łatki, podobnie jak przy prompt injection. Microsoft opisuje obronę warstwami, od wejścia do wyjścia:
- Filtrowanie wejścia. Osobny, prostszy model albo klasyfikator ocenia intencję rozmowy, zanim trafi do głównego modelu.
- Filtrowanie wyjścia. Odpowiedź jest sprawdzana jeszcze raz, zanim trafi do użytkownika.
- Uprawnienia, nie obietnice. Nawet udany jailbreak nie powinien dawać dostępu do niczego więcej, niż agent miałby i bez niego. To ta sama zasada, co w haśle prompt injection: polecenie w instrukcji systemowej to prośba, nie blokada. Blokadą są uprawnienia konta i ograniczenia po stronie infrastruktury.
- Monitoring rozmów. Nietypowo długie, wieloturowe rozmowy prowadzące w jedną stronę (jak w technice Crescendo) da się wychwycić automatycznie.
- Testy przed wdrożeniem. Sprawdzenie własnego chatbota albo agenta znanymi technikami, zanim zrobi to ktoś inny - to właśnie red teaming, którego AI Act wymaga od dużych dostawców modeli, a każda firma wdrażająca AI może zrobić we własnym, mniejszym zakresie.
Czy warto próbować jailbreaka samemu, dla zabawy?
Prawdopodobnie nie zadziała, i to jest najważniejsza informacja dla kogoś, kto chce spróbować gotowego promptu znalezionego w internecie. Historia w tabeli wyżej pokazuje wzór: technika się rozchodzi, a producent ją łata. Sama próba nie jest przestępstwem, ale narusza regulamin konta, więc w najgorszym razie kończy się banem. Do tego odpowiedź wymuszona jailbreakiem nie staje się przez to bardziej wiarygodna: model nadal może zmyślać, tylko robi to bez zastrzeżeń.
Najczęstsze pytania
Czy jailbreak AI jest nielegalny?
Zwykle nie - to naruszenie regulaminu dostawcy, nie przestępstwo. Odpowiedzialność prawna powstaje przy tym, co ktoś zrobi z wynikiem, nie przy samej rozmowie z modelem.
Czym różni się jailbreak od prompt injection?
Jailbreak to rozmowa, którą sam użytkownik prowadzi z modelem, próbując obejść jego zasady. Prompt injection działa szerzej i często bez wiedzy użytkownika - pełne wyjaśnienie w haśle prompt injection.
Czy da się całkowicie zablokować jailbreak?
Nie na trwałe. To wyścig między producentami modeli i osobami szukającymi nowych technik. Da się ograniczyć skutki (uprawnienia, filtry, monitoring), nie da się zagwarantować, że żadna rozmowa nigdy nie przejdzie.
Czy jailbreak AI to to samo co jailbreak telefonu?
Nazwa jest ta sama, mechanizm inny. Jailbreak telefonu odblokowuje funkcję, którą producent zablokował technicznie. Jailbreak AI nie odblokowuje niczego, co było zablokowane w kodzie - nakłania model, żeby przestał stosować zasadę, której się nauczył.
Czy mój firmowy chatbot albo agent AI może zostać zjailbreakowany?
Tak, jeśli korzysta z modelu językowego i rozmawia z ludźmi, których nie kontrolujesz. Ryzyko rośnie, gdy ten sam system ma też dostęp do narzędzi i danych firmy - sprawdź warstwy obrony wyżej.
Czy Wasz chatbot albo agent jest na to przygotowany?
Jailbreak, nadmiarowe uprawnienia i wstrzyknięcie instrukcji to trzy końce tego samego problemu: model robi więcej, niż powinien, bo nikt nie ograniczył tego poza samym poleceniem. Na szkoleniu z bezpieczeństwa i compliance AI przechodzimy te ryzyka na Waszych narzędziach - nie mamy w programie osobnego modułu z nazwą „jailbreak”, bo to zjawisko, które ogranicza się tymi samymi warstwami co resztę: uprawnieniami, filtrami i testami, nie jedną sztuczką.
Stan na 26 października 2026 r. Techniki jailbreaku i sposoby ich łatania zmieniają się w tygodniach, nie w latach, więc traktuj listę technik wyżej jako historię, nie jako aktualny stan zabezpieczeń konkretnego modelu.
Źródła
- Microsoft Security Blog, AI jailbreaks: what they are and how they can be mitigated, 04.06.2024.
- Mark Russinovich, Microsoft Security Blog, Mitigating Skeleton Key, a new type of generative AI jailbreak technique, 26.06.2024.
- Russinovich, Salem, Eldan, Great, Now Write an Article About That: The Crescendo Multi-Turn LLM Jailbreak Attack, arXiv 2404.01833, 02.04.2024.
- Anthropic, Many-shot jailbreaking, 02.04.2024.
- CERT/CC, VU#733789 (Time Bandit), 30.01.2025; sekurak.pl, Time Bandit, czyli jak zmusić ChatGPT-4o do złamania zasad, 06.02.2025.
- OWASP GenAI, LLM01:2025 Prompt Injection, i LLM06:2025 Excessive Agency.
- OpenAI, Usage Policies.
- EUR-Lex, AI Act (UE) 2024/1689, art. 55.